

Что получилось, когда я всё-таки доучил ИИ для Cardputer. Часть 2.
В прошлый раз я обещал: доучу модель — расскажу, что получилось. Расскажу честно: получилось не то, что я себе рисовал, когда писал последнюю строчку той статьи. И самое интересное было не в том, сколько это заняло, а в том, как модель теперь отвечает и почему именно так.
Напомню характеристики устройства. Внутри Cardputer стоит чип ESP32-S3: два ядра, частота до 0.24 ГГц. А памяти на всё устройство — 512 килобайт оперативной и 8 мегабайт постоянной. Для сравнения у меня в ПК частота процессора в 15 раз выше, а оперативной памяти больше в 32000 раз.
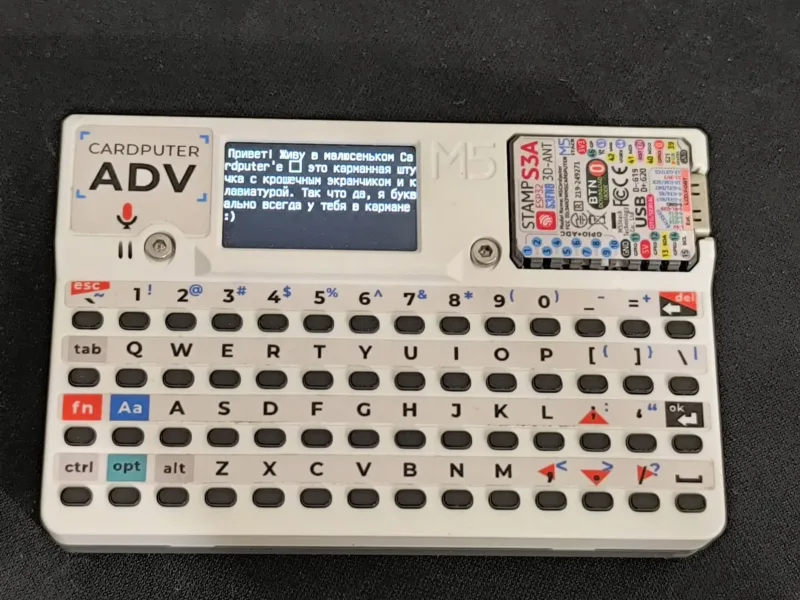
На моей видеокарте RTX 4060 время обучения неожиданно оказалось не главной проблемой — управился меньше чем за сутки. Главной проблемой оказалось совсем другое: не КАК ДОЛГО модель учится, а ЧЕМУ именно она учится.
Первый блин
Первую полную версию (назову её v1) я обучил на всём, что успел собрать, — почти 600 миллионов кусочков текста из пяти разных источников: архаичные литературные диалоги из книг, живая переписка из телеграм-чатов, форумные вопрос-ответы, синтетические реплики, сгенерированные другим ИИ. Дообучил до момента, когда кривая ошибки почти перестала падать, и стал проверять, что получилось.
Результат разочаровал не качеством, а характером. Я сравнил ответы по разным темам и заметил закономерность: на «спасибо» и «как дела» модель отвечала ровно и по делу, а на «привет» и «скучно» — то в тему, то будто её вообще другой человек написал. Разобрался: именно на первых двух темах все пять источников сходились по тону, а на вторых двух — расходились в разные стороны. Модель училась не одному голосу, а сразу пяти, и это было видно буквально по тому, какие темы у неё получались стабильно, а какие нет.
Второй косяк нашёлся отдельно и оказался забавнее. Среди данных был файл, который я написал сам, — примеры фраз именно в том тоне, который мне нужен от собственного устройства. Чтобы модель не забывала его среди миллионов чужих реплик, я показывал эти примеры ей в 115 раз чаще остальных. Слишком часто: на похожие вопросы модель начинала выдавать мои же фразы почти дословно, вместо того чтобы сочинять своё.
Не больше, а чище
Решение оказалось не «добавить ещё данных» и не «сделать модель крупнее», а наоборот — выкинуть источники, которые спорили друг с другом по тону, и оставить только те, что звучат одним голосом: живую переписку из телеграм-чатов плюс немного синтетики, по минимуму. Итоговый объём данных даже уменьшился — почти на сто миллионов кусочков текста, зато стал однородным. Свои же примеры стал показывать не в 115, а в 25 раз чаще — заметно скромнее. Размер самой модели не менял вообще — 6,6 миллиона параметров что в первой, что во второй версии.
Разница проявилась сразу: вторая версия дошла до того же уровня качества почти вдвое быстрее первой — не потому что считала быстрее, а потому что ей не приходилось разрываться между пятью манерами речи одновременно. Чистота материала оказалась сильнее рычага, чем его количество.
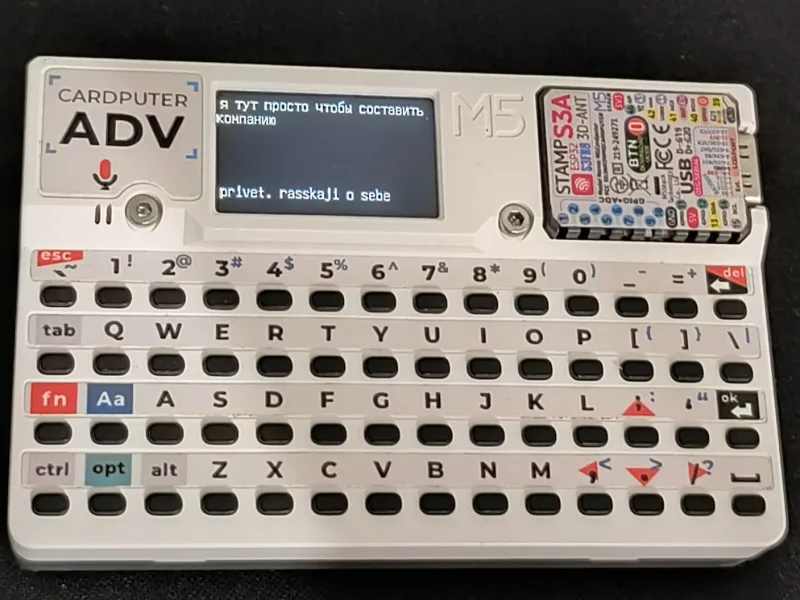
Вот честные примеры того, что модель отвечает сейчас (без подгонки, реальные ответы на реальные фразы):
privet -> приятней а подскаж
kak dela -> если ты слышишь, значит всё устраивает
skuchno -> в следующий раз руками сделать
spasibo -> знаю, что вы, мало твоих слов, у нас тоже так говор
Связной речи по-прежнему нет — а я надеялся. Но кое-что заметно изменилось: ответ на «kak dela» звучит почти по-человечески осмысленно — случайность это или нет, не знаю, но раньше таких попаданий не было вообще. И главное — разнобоя между фразами тоже не видно: даже неполные ответы держатся одного тона, а не скачут между книжным и форумным голосом, как в первой версии.
Проверка, которая чуть не подвела
Отдельная история — момент, который к качеству модели вообще не относится, но чуть не свёл на нет всю работу. Когда я сверял, что версия на устройстве отвечает так же, как версия на компьютере, первая проверка совпала с эталоном в 0 случаях из 9. Оказалось, часть кода на устройстве по ошибке подключала настройки от старой демо-версии вместо настоящей — с демкой это была случайность, которая никак себя не проявляла, а с настоящей моделью всё резко разошлось. После починки — 9 совпадений из 9. Не проверь я это числами, а на глаз, устройство бы уверенно отвечало ерундой, а я бы даже не заметил разницы.
Идея, до которой я пока не дошёл
Есть ещё одна мысль, которую я обдумал, но не реализовал. Сейчас у меня два независимых пути: классификатор, который узнаёт тему фразы среди 37 заготовленных, и обученная модель, которая пытается сочинять ответ сама. А что, если их соединить? Классификатор определяет тему — история, рецепты, школа — и передаёт фразу не одной универсальной модели, а специальной, обученной только на этой теме: одна по истории, одна по рецептам, и так далее. В оперативной памяти устройства сначала лежит только классификатор, он определяет тему и выгружается, а его место занимает модель, обученная для этой темы, которая все это время лежала на SD карте.
Логика простая: универсальной модели на 6,6 миллиона параметров приходится держать в голове всё сразу — болтовню, шутки, вопросы про что угодно, — и на это её попросту не хватает. Модели про рецепты нужно знать несколько сотен слов и десяток привычных оборотов вроде «нарежь», «посоли», «добавь через десять минут». Чем уже тема, тем меньше нужно, чтобы говорить в ней связно.
Почему не сделал: сначала хотел понять, на что вообще способна одна базовая модель, — и только потом делить её на специалистов. Большая проблема - найти данные для каждой из маленьких моделек.
Что в итоге
Если подводить черту под всей затеей: путь с классификатором и выбором готовых ответов (тот, что был в прошлой статье под первым номером) как работал уверенно, так и работает — это готовый, надёжный кусок устройства. Путь со своей обученной с нуля моделью после этой сессии перестал быть просто демкой: он честно говорит одним голосом, отдельные слова осмысленны, изредка попадаются почти человеческие фразы — но до настоящего связного разговора ему ещё далеко. Не то что я обещал в мечтах, но настоящий, измеримый шаг вперёд — и я теперь точно знаю, за счёт чего его можно сделать ещё раз.
Пока ждал — собрал голос погромче
Пока разбирался, что реально можно выжать из собственной модели, я собрал для Cardputer ещё один способ разговаривать — уже не свою обученную модель, а чат с настоящим большим ИИ (DeepSeek) через Wi-Fi. Устройство отправляет фразу в облако и показывает нормальный, связный ответ — то, чего моя собственная модель пока физически не может дать. Для маскировки на устройстве есть «паник-кнопка»: двойное нажатие клавиши мгновенно превращает экран в обычный калькулятор.
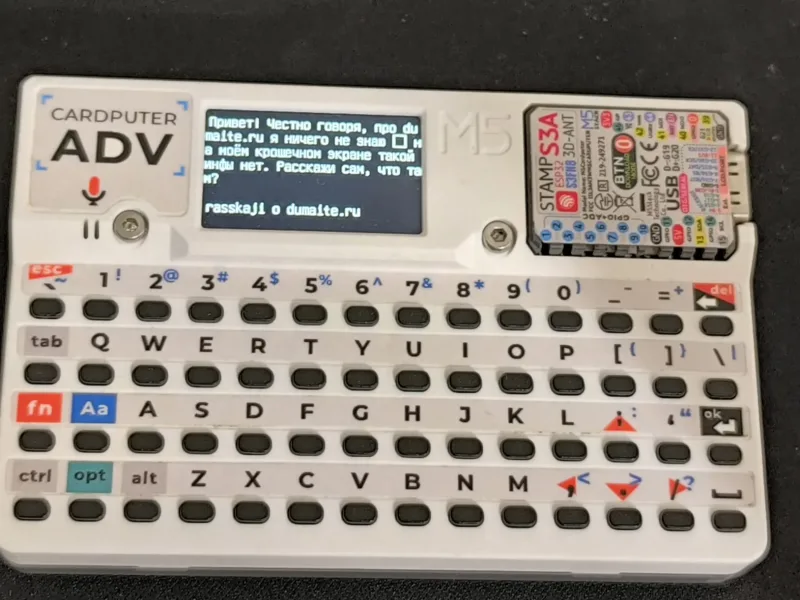
Это уже другая история, чем всё, что было выше, — там я разговариваю не со своей локальной нейросетью, а через Cardputer по API с чужой, уже готовой и по-настоящему большой.
И вот здесь всплыл честный вопрос: а можно ли когда-нибудь сделать так, чтобы моя СОБСТВЕННАЯ модель говорила так же связно, без чужого облака и интернета? Ответ — да, рецепт существует, и он снова про данные, а не про размер. Есть подход (доказанный ещё исследованием Microsoft 2023 года), который заставляет говорить связно даже модели размером 1-33 миллиона параметров — если обучать их не на сыром слепке случайных разговоров, а на специально сгенерированном, идеально чистом и простом по языку тексте. Проблема в том, что такой текст в нужном объёме — 300-800 миллионов образцов — руками не напишешь, его нужно заказывать через API большого ИИ. По нынешним ценам это 200-550 долларов, то есть по сути около полутысячи. Есть и бесплатный вариант — сгенерировать всё это самому на своей видеокарте, но тогда вместо часов уйдут месяцы непрерывной работы, а значит, это не бесплатно, а просто нереалистично медленно.
Так что рецепт для по-настоящему говорящей собственной модели существует целиком, от и до. Не хватает только одного — денег. Не идей и не мощности. Это как раз тот случай, когда пора честно признать «пока не потяну» .
А к моменту написания статьи у меня готовы уже несколько других интересных проектов. Я смог запустить на cardputer видео со звуком, прошил 16 андроид на телефон 2018 года и еще кое-что.
P.S Полностью написал эту статью несколько дней назад однако сейчас работал с Claude Opus над другим проектом в котором тоже нужна была модель на 6 млн параметров и он нашел пару ошибок в этом проекте (где я использовал только Claude Sonnet) и предложил как все таки можно заставить модель такого размера связно разговаривать. Поэтому возможно это не конец а только начало.
 Роман Раевский
Поддержать автора
- номер счёта/карты
- 2200 2479 6702 4085
- получатель
- Раевский Роман

Комментарии 2
Войдите, чтобы оставить комментарий.